bucketcode
- Durée
- 2 semaines
- Date
- Août 2026
+3
Préambule
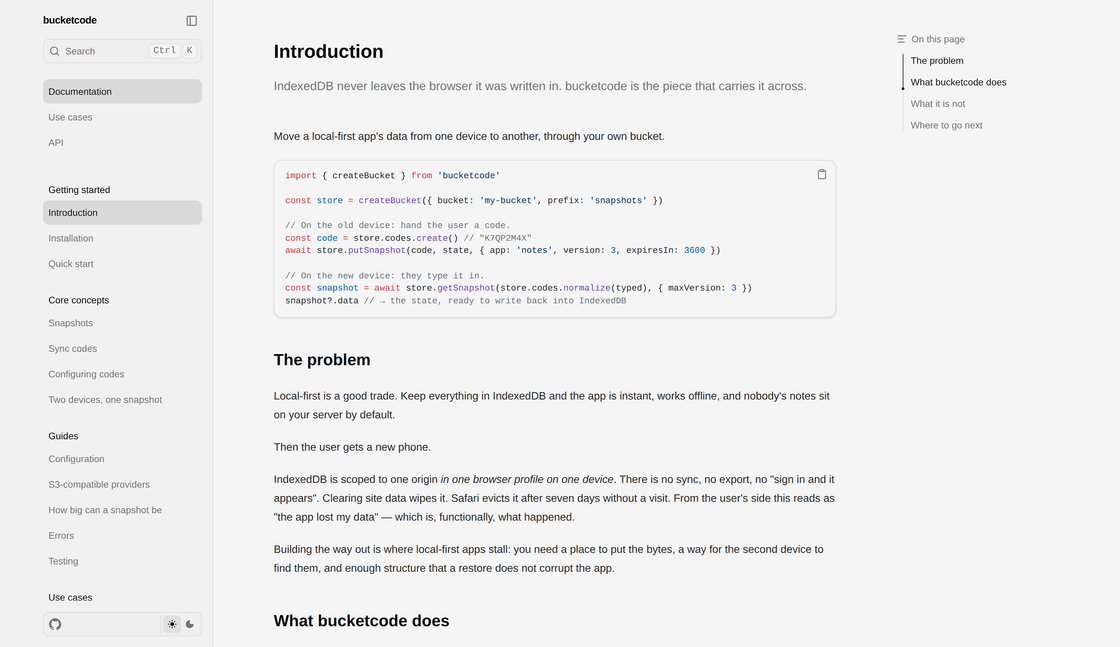
Le local-first est un bon compromis. Tout garder dans IndexedDB rend l'app instantanée, elle fonctionne hors ligne et les notes de personne ne dorment sur votre serveur par défaut. Puis l'utilisateur change de téléphone, et l'app est vide. IndexedDB est limité à une origine, dans un profil de navigateur, sur un appareil.
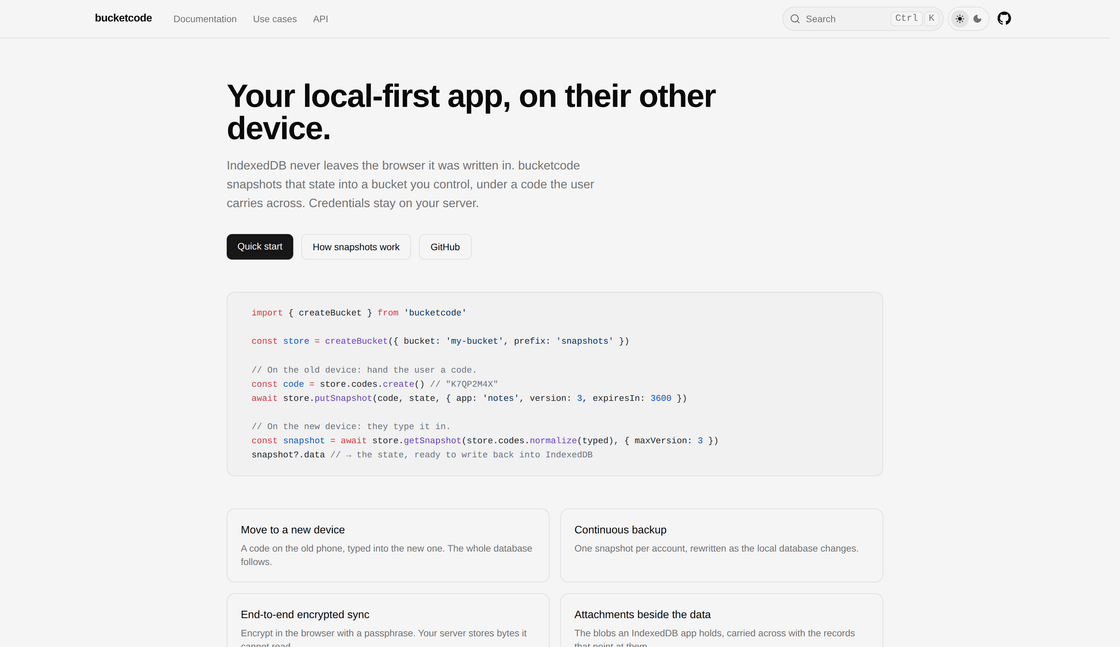
bucketcode est la petite brique côté serveur qui fait passer cet état d'un appareil à l'autre. Elle sérialise l'état local de l'app dans un snapshot auto-descriptif, le compresse en gzip et le dépose dans un bucket compatible S3 contrôlé par le développeur, rangé sous un code de synchronisation court que l'utilisateur lit sur l'ancien appareil et tape sur le nouveau.
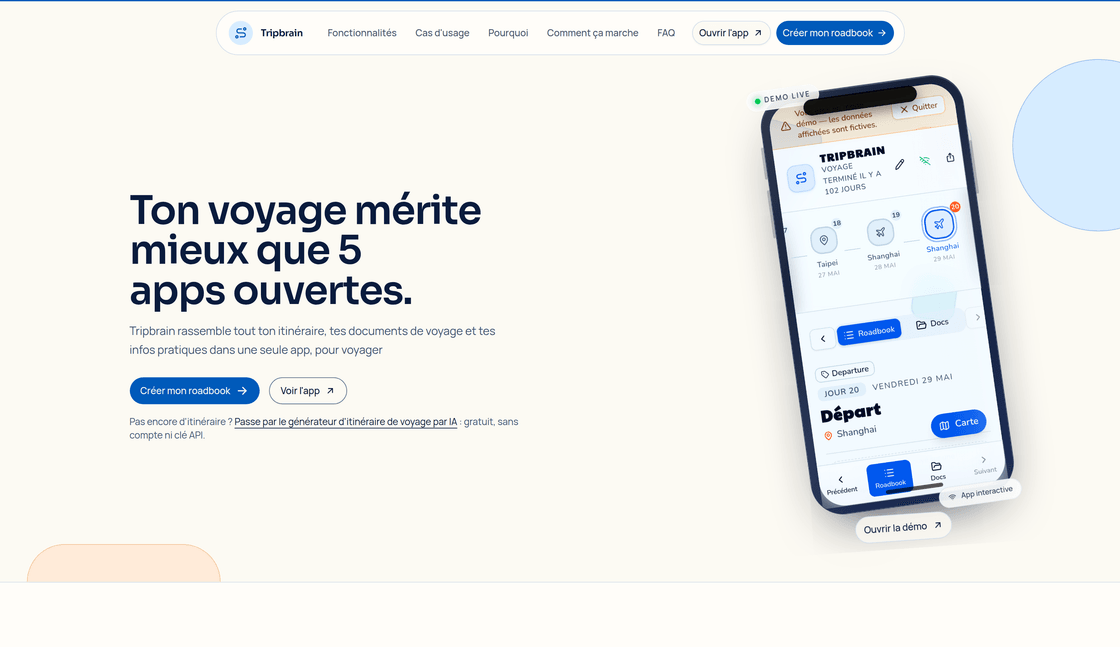
Je l'ai extraite de TripBrain, où elle fait tourner le partage entre appareils. Elle est publiée sur npm sous le nom bucketcode, licence MIT : bucketcode sur GitHub.
Stack technique
- TypeScript, Node.js 20+, builds ESM et CommonJS avec types embarqués
- AWS SDK v3 pour S3, compatible AWS S3, Cloudflare R2, MinIO, Scaleway, Wasabi
- tsup, Vitest, pnpm workspaces, Turborepo
- Fumadocs et Next.js 16 pour le site de documentation
- GitHub Actions, release-please, provenance npm
Fonctionnalités clés
- Snapshots compressés en gzip avec une enveloppe auto-descriptive
- Verrouillage par version de schéma pour qu'une vieille app ne charge jamais des données qu'elle ne sait pas lire
- Expiration côté serveur, appliquée à la lecture plutôt que déléguée aux règles de cycle de vie du bucket
- Génération de codes de synchronisation couplée à une normalisation tolérante (Crockford base32 par défaut)
- Écritures conditionnelles pour que deux appareils en concurrence ne perdent jamais de données en silence
- Une API fichier simple en dessous : upload, put, get, getUrl, delete
En détail
Le choix d'architecture, c'est que le navigateur ne parle jamais au bucket. Des uploads présignés impliqueraient du CORS sur le bucket du client et une signature côté navigateur ; bucketcode fait passer la charge utile par l'API du développeur, ce qui supprime toute configuration du bucket au prix d'un plafond de taille. La documentation indique ce plafond par runtime (Lambda, Vercel, Netlify, Next.js) plutôt que de le cacher, et explique que le ratio de cinq à dix du gzip sur du JSON répétitif est ce qui donne la marge.
Les codes de synchronisation sont toute l'expérience utilisateur du passage d'un appareil à l'autre. Génération et normalisation viennent de la même configuration, si bien qu'elles ne peuvent jamais être en désaccord sur l'alphabet. Les caractères ambigus ne sont repliés que quand l'alphabet le permet sans équivoque : un « O » se lit comme un zéro seulement s'il n'y a pas de lettre « O » avec laquelle le confondre. L'objet code expose aussi son entropie en bits, pour qu'un développeur puisse raisonner sur ce que vaut un code raccourci face à une tentative de devinette.
Chaque snapshot porte sa propre version de format d'enveloppe, distincte de la version de schéma de l'app. La compression est détectée à partir des octets magiques gzip plutôt que supposée, donc les anciens snapshots non compressés se chargent toujours. Les clés sont traitées comme des entrées non fiables : traversée de répertoires, caractères de contrôle et clés trop longues sont rejetés avant tout appel réseau.
Rôle
Projet solo : conception et implémentation de la librairie, suite de tests, site de documentation, deux exemples exécutables et pipeline de publication.
Ce que j'ai construit
La librairie
- API de snapshots au-dessus d'une API fichier, avec 13 codes d'erreur stables et l'erreur d'origine conservée en cause
- Expiration appliquée à la lecture : un snapshot expiré renvoie null même si l'objet est encore dans le bucket
- Écritures conditionnelles normalisées sur le comportement réel de S3 (412 et 409, ETags avec ou sans guillemets)
- Création paresseuse du client pour que le store soit peu coûteux à importer au niveau module pendant un build Next.js
- Porte de sortie vers le S3Client sous-jacent
Tester sans identifiants
- Un double S3 en mémoire qui respecte les en-têtes conditionnels, pour que les chemins de concurrence soient réellement exercés
- 121 cas de test répartis dans 10 fichiers, entièrement hors ligne, exécutés sur Node 20, 22 et 24 en CI
- La même technique documentée pour les utilisateurs de la librairie dans un guide de test
Documentation et exemples
- 17 pages de documentation : démarrage, concepts, guides, cas d'usage, référence d'API
- Un guide de synchronisation chiffrée avec PBKDF2 et AES-GCM côté navigateur, pour que le serveur stocke un chiffré qu'il ne peut pas lire
- Un exemple Next.js : une app de notes dans IndexedDB avec des routes de synchronisation
- Un script Node qui prouve l'aller-retour complet : ratio de compression, normalisation d'un code mal tapé, les deux écritures conditionnelles, invalidation d'un code
Ingénierie de publication
- release-please piloté par les commits conventionnels, limité au dossier de la librairie pour que seuls ses changements déclenchent une version
- Vérification du titre des PR comme signal de version, squash merges
- Publication npm avec provenance via OpenID Connect trusted publishing
Réalisations techniques
Un problème étroit, résolu complètement
Le périmètre tient en une chose : transférer l'état d'une app local-first entre appareils via un bucket que vous possédez. Tout ce qui l'entoure (versions, expiration, concurrence, ergonomie des codes, limites de taille) est géré et documenté plutôt que laissé à l'intégrateur.
Utilisée en production
TripBrain s'appuie sur bucketcode pour ses codes de partage à 8 chiffres sur Cloudflare R2, avec une expiration d'une heure et des écritures conditionnelles pour qu'un code ne soit jamais écrasé.
En résumé
bucketcode est une librairie open source ciblée et bien testée qui donne aux apps local-first la seule chose qui leur manque : un moyen de suivre l'utilisateur jusqu'à son prochain appareil, sans backend et sans confier d'identifiants au navigateur.
Projets similaires